진동 데이터 머신러닝 기초, 임계값 경보와 학습 모델의 차이
작성일
안녕하세요. 산업 설비 상태감시와 예지보전 솔루션 전문기업 유센스입니다.
진동센서로 설비를 감시할 때 가장 많이 쓰는 방식은 임계값 경보입니다.
진동 크기가 기준을 넘으면 경보가 울리는 구조라서,
부하나 회전수가 바뀔 때마다 헛경보가 나고 진동 변화가 작은 초기 베어링 이상은 놓치기 쉽습니다.
머신러닝은 진동 크기 하나가 아니라 여러 진동 특징과 운전 조건을 함께 학습해서 평소와 다른 패턴을 찾아내는 방식으로 이상 감지를 합니다.
이번 글에서는 머신러닝 기초로 두 방식의 차이를 살펴보고,
지금 가진 진동 데이터로 어디까지 분석할 수 있는지 정리해 보겠습니다.
임계값 경보가 놓치는 두 가지 상황
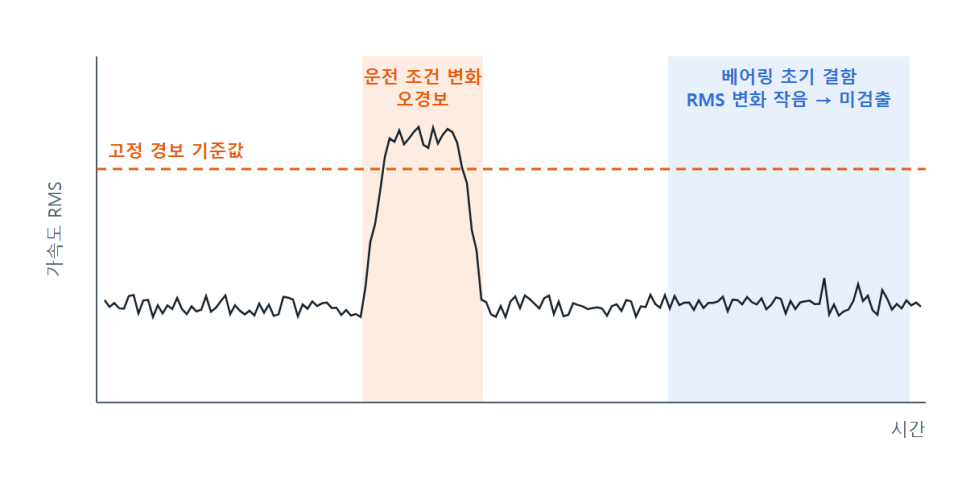
임계값 경보는 가속도 RMS나 속도 RMS처럼, 기준으로 삼을 지표와 알람을 낼 수치를 먼저 정해 두는 방식입니다.
기준값은 ISO 20816 같은 규격이나 설비 이력에서 정합니다.
기준이 분명해 현장에서 쓰기 쉽지만 아래 두 상황에서는 설비 상태를 판단하기 어려워집니다.
첫째, 부하와 회전수가 바뀌거나 정지와 운전을 반복하면 정상 진동 범위도 함께 달라집니다.
고정된 기준값은 정상적인 운전 변화에도 경보를 낼 수 있습니다.
둘째, 베어링 초기 결함은 충격 에너지가 작아 광대역 RMS에 큰 변화가 나타나지 않을 수 있습니다.
유센스가 시험 설비에 결함 베어링을 장착해 진행한 내부 시험에서,
외륜 결함의 광대역 RMS는 정상 대비 0.99배로 거의 그대로였습니다.
같은 파형을 포락 복조로 분석한 RMS는 1.66배로 나타났습니다.
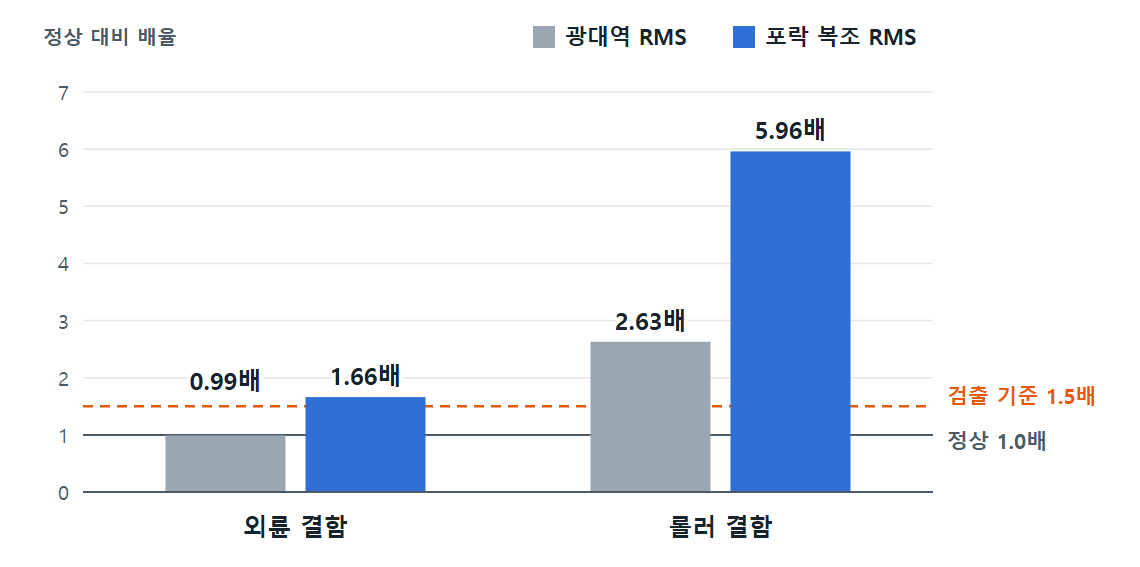
수치 하나로는 운전 조건 변화와 결함을 함께 구분하기 어렵다는 뜻입니다.
머신러닝은 이 차이를 여러 특징값의 조합에서 찾습니다.
머신 러닝은 여러 진동 특징을 함께 봅니다
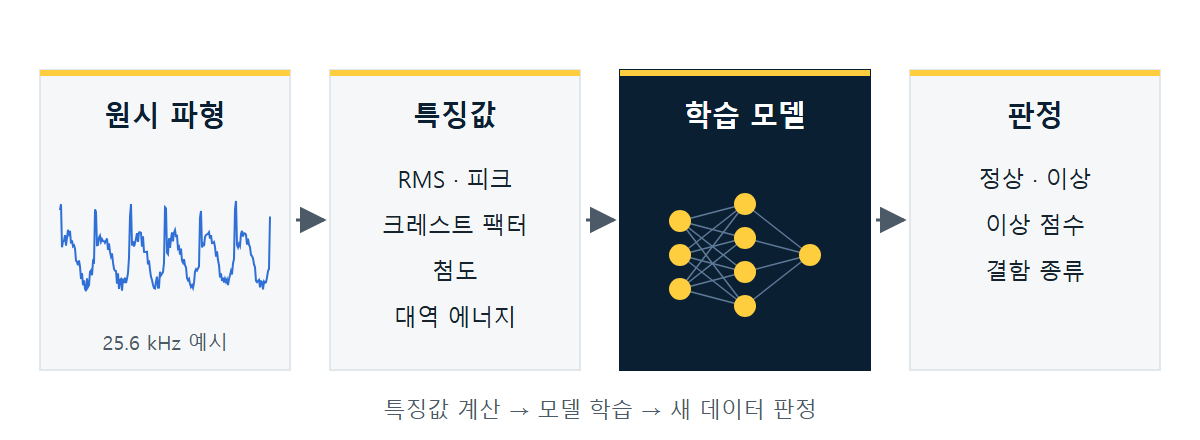
학습 모델은 기준값을 사람이 정하지 않고 데이터에서 찾습니다.
원시 파형에서 계산한 RMS, 피크, 크레스트 팩터, 첨도, 대역 에너지 같은 여러 값을 함께 사용해 판정 기준을 만듭니다.
같은 특징값도 회전수와 부하에 따라 달라지기 때문에 운전 정보도 같이 기록해야 합니다.
여러 값을 함께 보는 이유는 결함마다 크게 반응하는 지표가 다르기 때문입니다.
같은 베어링 시험에서 결함 6종 평균으로 보면 광대역 RMS는 정상 대비 1.29배에 그쳤지만,
결함 주파수 성분 중 케이지 반복 성분은 9.02배, 롤러 반복 성분은 4.42배였습니다.
| 항목 | 임계값 경보 | 학습 모델 |
|---|---|---|
| 입력 | 지표 1개 | 특징값 여러 개 |
| 기준 결정 | 규격·경험 | 데이터에서 학습 |
| 출력 | 정상·경보 | 이상 점수, 결함 종류 |
| 필요한 데이터 | 거의 없음 | 정상 데이터, 가능하면 결함 데이터 |
반대로 케이지 미세크랙은 9개 지표 모두에서 정상과 뚜렷하게 구분되지 않았습니다.
진동 데이터에 차이가 담기지 않으면 학습 모델도 그 결함을 찾아낼 수 없습니다.
결국 머신러닝으로 무엇을 할 수 있는지는 보유한 데이터가 결정합니다.
내 진동 데이터로 어디까지 할 수 있을까?
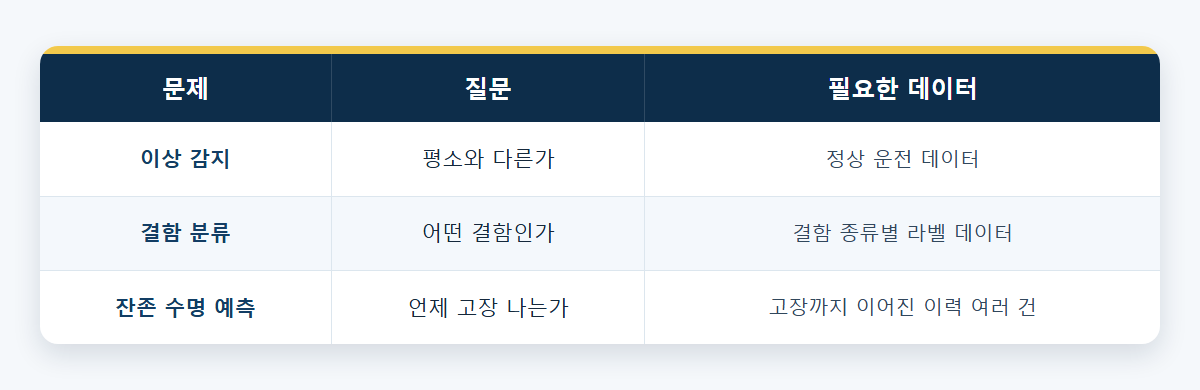
머신러닝으로 다루는 문제는 크게 3가지이고, 필요한 데이터가 각각 다릅니다.
① 이상 감지
정상 운전 데이터를 쌓아 두고, 평소 범위에서 얼마나 벗어났는지 이상 점수로 확인합니다.
정상 데이터만 있어도 시작할 수 있어 현장에서 가장 먼저 적용하기 좋습니다.
② 결함 분류
외륜 손상, 내륜 손상, 케이지 파손처럼 결함 종류를 구분하려면 종류별로 라벨이 붙은 데이터가 필요합니다.
유센스 베어링 시험처럼 정상과 결함 상태를 구분해 기록한 데이터가 여기에 해당합니다.
이 시험에서는 정상 2종과 결함 6종을 25.6 kHz로 기록했습니다.
③ 잔존 수명 예측
고장까지 얼마나 남았는지 예측하려면 같은 종류의 설비가 실제 고장으로 이어진 이력이 여러 건 있어야 합니다.
현장마다 운전 조건과 정비 방식이 달라 아직 적용 사례가 많지 않습니다.
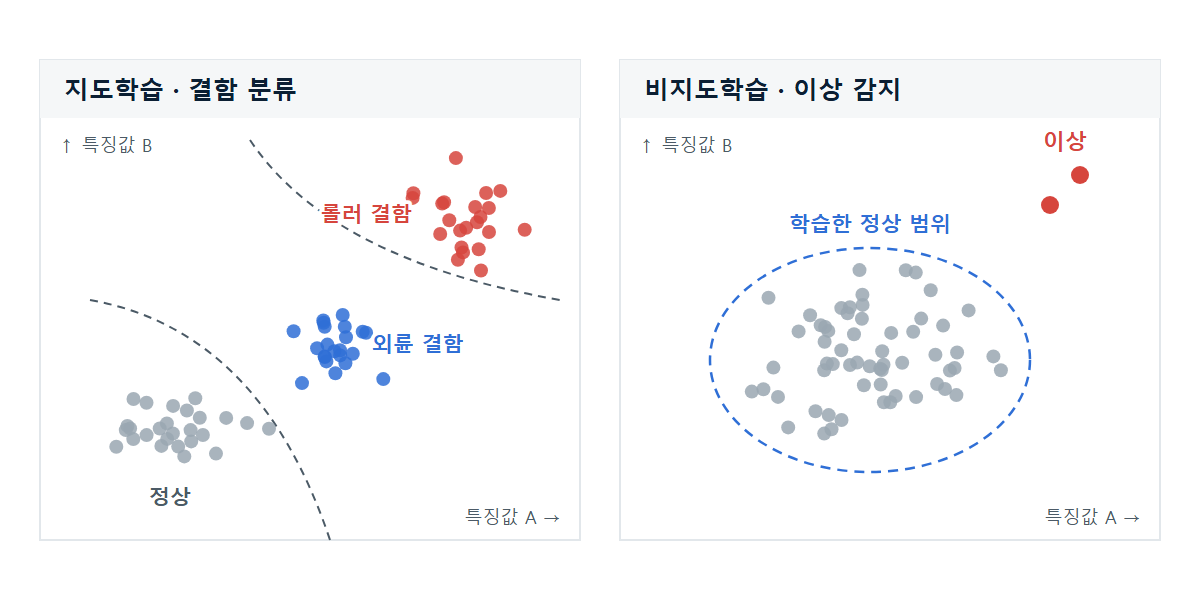
이상 감지처럼 정상 데이터만으로 학습하는 방식을 비지도학습,
결함 분류처럼 라벨이 붙은 데이터로 학습하는 방식을 지도학습이라고 합니다.
지도학습에 쓰는 라벨은 정비 기록과 함께 만들어야 합니다.
부품 교체 뒤 안정된 운전 구간은 정상으로 두고, 교체 직전 분해 점검에서 확인한 결함 이름은 해당 구간 데이터에 붙입니다.
결함이 시작된 시점을 정확히 알기 어려운 경계 구간은 학습 데이터에서 빼는 편이 좋습니다.
교체 날짜만 있고 분해 결과가 없다면 결함 종류를 확정할 수 없습니다.
이런 데이터는 결함 분류보다 이상 감지에 활용하는 것이 맞습니다.
적용 전 보유 데이터를 먼저 확인해야 합니다
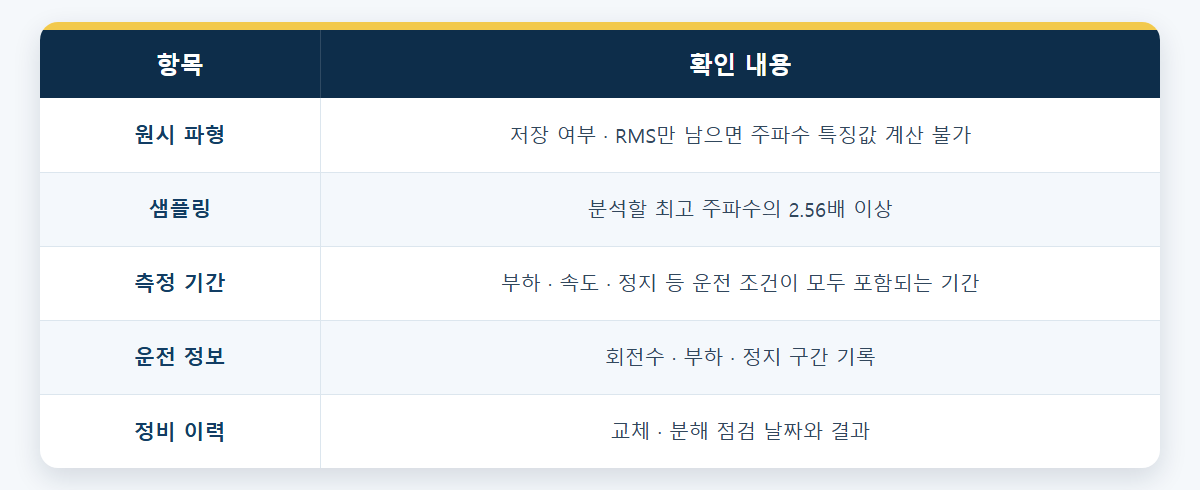
현장에서 먼저 확인할 항목은 다섯 가지입니다.
① 원시 파형 저장 여부
RMS만 남아 있으면 주파수 성분이나 포락 복조 같은 특징값을 새로 계산할 수 없습니다.
② 샘플링 조건
샘플링 주파수가 분석하려는 최고 주파수의 2.56배 이상이어야 필요한 진동 성분을 확인할 수 있습니다.
③ 운전 정보
회전수, 부하, 정지 구간을 함께 남겨야 운전 조건에 따른 정상 범위를 구분할 수 있습니다.
④ 정비 이력
부품 교체일과 분해 점검 결과가 있어야 정상·결함 라벨을 신뢰할 수 있습니다.
⑤ 측정 기간
부하, 속도, 정지 등 운전 조건이 모두 한 번 이상 나타나는 기간이 필요합니다.
유센스 기준선 설정 사례에서는 16일 동안 측정해 운전 구간 31개를 확보했습니다.
무선 진동센서 데이터도 종류에 따라 활용 범위가 달라집니다.
가속도·속도 RMS, 크레스트 팩터, 온도를 보내는 SVT-V 계열은 이상 감지에 활용할 수 있습니다.
결함 종류까지 분류하려면 3축 원시 파형을 보내는 SVT-A 계열 데이터가 필요합니다.
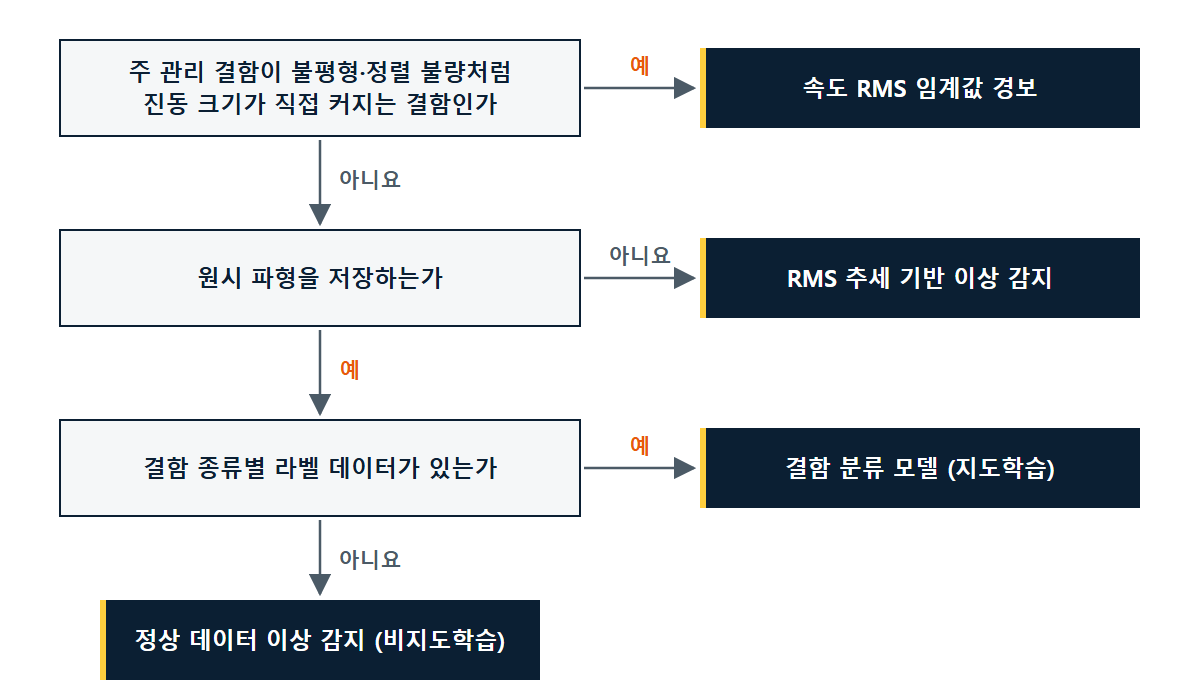
모든 설비에 머신러닝이 필요한 것은 아닙니다.
불평형이나 축정렬 불량처럼 진동 크기가 직접 커지는 결함이 주 관리 대상이라면 속도 RMS 임계값 경보로도 충분할 수 있습니다.
반면 초기 베어링 이상이나 운전 조건별 변화를 구분해야 한다면, 원시 파형과 운전 이력을 함께 쌓는 방식이 필요합니다.
머신러닝은 모든 설비에 같은 방식으로 적용하는 기능이 아닙니다.
어떤 이상을 찾으려는지, 현재 어떤 진동 데이터와 정비 이력이 남아 있는지에 따라 적용 범위가 달라집니다.
진동 데이터 기반 이상 감지나 예지보전 적용을 준비하고 있다면 유센스에 문의해 주세요.
사용 중인 진동센서와 데이터 저장 방식, 설비 운전 조건에 맞춰 필요한 측정 항목을 안내해 드리겠습니다.